

Если требуется что-то более экзотичное
Есть такой метод, который изначально разрабатывался для разложения сигнала с аддитивными компонентами — я говорю об
. При этом принимается гипотеза, что эти компоненты имеют не нормальное распределение, и их источники независимы. Простейший пример —
, где множество голосов смешиваются, и стоит задача выделить каждый звуковой сигнал от каждого источника. Для поиска независимых компонент обычно используют два подхода: 1) с минимизацией
на основе дивергенции
; 2)с максимизацией «негауссовости» (тут используются такие меры как
На картинке ниже — простой пример, где смешиваются две синусоиды, потом они же с помощью ICA и выделяются.
x <- seq(0, 2*pi, length.out=5000)
y1 <- sin(x)
y2 <- sin(10*x pi)
S <- cbind(y1, y2)
A <- matrix(c(1/3, 1/2, 2, 1/4), 2, 2)
y <- S %*% A
library(fastICA)
IC <- fastICA(y, 2)
par(mfcol = c(2, 3))
plot(x, y1, type="l", col="blue", pch=19, cex=0.1, xlab="", ylab="", main="Исходные сигналы")
plot(x, y2, type="l", col="green", pch=19, cex=0.1, xlab = "", ylab = "")
plot(x, y[,1], type="l", col="red", pch=19, cex=0.5, xlab = "", ylab = "", main="Смешанные сигналы")
plot(x, y[,2], type="l", col="red", pch=19, cex=0.5, xlab = "", ylab = "")
plot(x, IC$S[,1], type="l", col="blue", pch=19, cex=0.5, xlab = "", ylab = "", main="ICA")
plot(x, IC$S[,2], type="l", col="green", pch=19, cex=0.5, xlab = "", ylab = "")
Какое отношение имеет ICA к задаче уменьшения размерности данных? Попробуем представить данные — вне зависимости от их природы — как смесь компонент, тогда можно будет разделить эту смесь на то количество «сигналов», которое нам подходит. Особого критерия, как в случае с PCA, по выбору количества компонент нет — оно подбирается экспериментально.
Последний подопытный в этом обзоре — автоэнкодеры, которые представляют собой особый класс нейронных сетей, настроенных таким образом, чтобы отклик на выходе автокодировщика был максимально близок к входному сигналу. Со всей мощью и гибкостью нейронных сетей мы одновременно получаем и массу проблем, связанных с поиском оптимальных параметров: количества скрытых слоев и нейронов в них, функции активации (sigmoid, tanh, ReLu,), алгоритма обучения и его параметров, способов регуляризации (L1, L2, dropout).
Если обучать автоэнкодер на зашумленных данных с тем, чтобы сеть восстанавливала их, то получается denoising autoencoder . Предварительно настроенные автокодировщики также можно «стыковать» в виде каскадов для предобучения глубоких сетей без учителя.
В самом простом представлении автоэнкодер можно смоделировать как многослойный перцептрон, в котором количество нейронов в выходном слое равно количеству входов. Из рисунка ниже понятно, что, выбирая промежуточный скрытый слой малой размерности, мы тем самым «сжимаем» исходные данные.
Собственно, в пакете
, который я упоминал выше, такой автоассоциатор присутствует, поэтому будем использовать его. Сначала я хотел показать пример с
, но быстро убедился, что несколькими предложениями тут не отделаешься, поэтому далее будут картинки с
набившими всем оскомину
рукописными цифрами из этого
Данные представлены в виде .csv файлов (train.csv и test.csv), их довольно много, поэтому в дальнейшем для упрощения я буду работать с 10% данных из train.csv; колонка с метками (labels) будет использоваться только для целей визуализации. Но прежде чем выясним, что можно сделать с помощью автоэнкодера, посмотрим, что дают нам первые три компоненты при разложении PCA, ICA, NMF:
Все три метода неплохо справились с задачей кластеризации — на изображении более-менее отчетливо видны группы, плавно переходящие друг в друга. Вот эти переходы — пограничные случаи, когда цифры особенно сложны для распознавания. На рисунке с кластерами PCA очень хорошо заметно, как метод главных компонент решает важную задачу — декоррелирует переменные:
train <- read.csv("train.csv")
label <- data$label
train$label <- NULL
train <- train / max(train)
# Подготовка выборки для обучения
library(caret)
tri <- createDataPartition(label, p=0.1)$Resample1
train <- train[tri, ]
label <- label[tri]
# Запуска кластера h2o
library(h2o)
h2o.init(nthreads=4, max_mem_size='14G')
train.h2o <- as.h2o(train)
# Обучение автоэнкодера и выделение фич
m.deep <- h2o.deeplearning(x=1:ncol(train.h2o), training_frame=train.h2o, activation="Tanh", hidden=c(150, 25, 3, 25, 150), epochs=600, export_weights_and_biases=T, ignore_const_cols=F, autoencoder=T)
deep.fea <- as.data.frame(h2o.deepfeatures(m.deep, train.h2o, layer=3))
library(rgl)
palette(rainbow(length(unique(labels))))
plot3d(deep.fea[, 1], deep.fea[, 2], deep.fea[, 3], col=label 1, type="s", size=1, box=F, axes=F, xlab="", ylab="", zlab="", main="AEC") Тут кластеры более четко определены и разнесены в пространстве. У сети довольно простая архитектура с 5 скрытыми слоями и небольшим количеством нейронов; в третьем скрытом слое всего 3 нейрона, и фичи оттуда как раз и изображены выше. Еще немного занимательных картинок:
На самом деле, это всего лишь изображения весов нейронов: каждая картинка ассоциируется с отдельным нейроном и представляет фильтр, который выделяет специфичную для данного нейрона информацию. Вот для сравнения весы выходного слоя:
Вышеозначенный автоэнкодер несложно превратить в denoising autoencoder. Так как такому автокодировщику на вход надо подавать искаженные образы, перед первым скрытым слоем достаточно разместить
. Благодаря ему с некоторой вероятностью нейроны будут находиться в «выключенном» состоянии, что а) будет вносить искажения в обрабатываемый образ; б) будет служить своеобразной регуляризацией при обучении.
Еще одно интересное применение автоэнкодера — определение аномалий в данных по ошибке реконструкции образов. В целом, если подавать на вход автоэнкодера данные не из обучающей выборки, то, понятно, ошибка реконструкции каждого образа из новой выборки будет выше таковой из тренировочной выборки, но более-менее одного порядка. При наличии аномалий эта ошибка будет в десятки, а то и сотни раз больше.
Системы линейных алгебраических уравнений. основные определения
Построение математических моделей процессов и явлений во всех сферах деятельности человека требует разработок соответствующего математичноrо аппарата, и системы линейных алгебраических уравнений является его важной составляющей. Эти уравнения играют важную роль и при построении математических моделей экономических процессов.
Системой линейных алгебраических уравнений (СЛАУ) называется совокупность 


 (матричная форма системы)Приведем еще один способ представления системы уравнений с помощью матриц. Пусть матрица-столбец


 основной матрицей системы. Присоединяя справа (через вертикальную черту) к матрице


 расширенной матрицей системы:
Понятно, что операции над строками расширенно и матрицы являются операциями над соответствующими уравнениями системы.
Решением системы уравнений называется такой набор чисел 

Система линейных алгебраических уравнений называется совместной, если она имеет по крайней мере одно решение, и несовместимой, если она не имеет никакого решения. Совместимую систему уравнений называют определенной, если она имеет единственное решение, и неопределенной, если количество решений более одного.
Система линейных уравнений называется неоднородной, если хотя бы один элемент матрицы-столбца свободных членов отличается от нуля. Если все элементы  однородной. Однородная система уравнений имеет вид:где


Действия с матрицами
Данное методическое пособие поможет Вам научиться выполнять действия с матрицами: сложение (вычитание) матриц, транспонирование матрицы, умножение матриц, нахождение обратной матрицы. Весь материал изложен в простой и доступной форме, приведены соответствующие примеры, таким образом, даже неподготовленный человек сможет научиться выполнять действия с матрицами.
Для самоконтроля и самопроверки Вы можете бесплатно скачать матричный калькулятор >>>.
Я буду стараться минимизировать теоретические выкладки, кое-где возможны объяснения «на пальцах» и использование ненаучных терминов. Любители основательной теории, пожалуйста, не занимайтесь критикой, наша задача – научиться выполнять действия с матрицами.
Для СВЕРХБЫСТРОЙ подготовки по теме (у кого «горит») есть интенсивный pdf-курс Матрица, определитель и зачёт!
Начнем.
Матрица – это прямоугольная таблица каких-либо элементов. В качестве элементов мы будем рассматривать числа, то есть числовые матрицы. ЭЛЕМЕНТ – это термин. Термин желательно запомнить, он будет часто встречаться, не случайно я использовал для его выделения жирный шрифт.
Обозначение: матрицы обычно обозначают прописными латинскими буквами 
Пример: рассмотрим матрицу «два на три»:
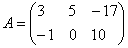
Данная матрица состоит из шести элементов: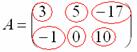
Все числа (элементы) внутри матрицы существуют сами по себе, то есть ни о каком вычитании речи не идет: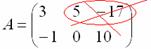
Это просто таблица (набор) чисел!
Также договоримся не переставлять числа, если иного не сказано в объяснениях. У каждого числа свое местоположение, и перетасовывать их нельзя!
Рассматриваемая матрица имеет две строки: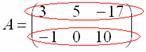
и три столбца: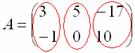
СТАНДАРТ: когда говорят о размерах матрицы, то сначала указывают количество строк, а только потом – количество столбцов. Мы только что разобрали по косточкам матрицу «два на три».
Если количество строк и столбцов матрицы совпадает, то матрицу называют квадратной, например: 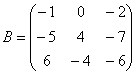 – матрица «три на три».
Если в матрице один столбец  или одна строка
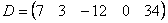 , то такие матрицы также называют векторами.
На самом деле понятие матрицы мы знаем еще со школы, рассмотрим, например точку с координатами «икс» и «игрек»:  . По существу, координаты точки
 записаны в матрицу «один на два». Кстати, вот Вам и пример, почему порядок чисел имеет значение:
 и
 – это две совершенно разные точки плоскости.
Теперь переходим непосредственно к изучению действий с матрицами:
1) Действие первое. Вынесение минуса из матрицы (внесение минуса в матрицу).
Вернемся к нашей матрице 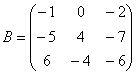 . Как вы наверняка заметили, в данной матрице слишком много отрицательных чисел. Это очень неудобно с точки зрения выполнения различных действий с матрицей, неудобно писать столько минусов, да и просто в оформлении некрасиво выглядит.
Вынесем минус за пределы матрицы, сменив у КАЖДОГО элемента матрицы знак: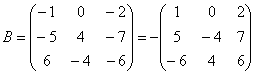
У нуля, как Вы понимаете, знак не меняется, ноль – он и в Африке ноль.
Обратный пример: 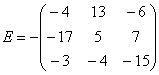 . Выглядит безобразно.
Внесем минус в матрицу, сменив у КАЖДОГО элемента матрицы знак:
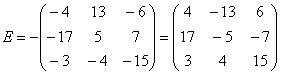
Ну вот, гораздо симпатичнее получилось. И, самое главное, выполнять какие-либо действия с матрицей будет ПРОЩЕ. Потому что есть такая математическая народная примета: чем больше минусов – тем больше путаницы и ошибок.
2) Действие второе. Умножение матрицы на число.
Пример:
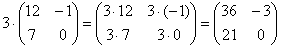
Всё просто, для того чтобы умножить матрицу на число, нужно каждый элемент матрицы умножить на данное число. В данном случае – на тройку.
Еще один полезный пример:
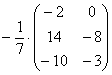 – умножение матрицы на дробь
Сначала рассмотрим то, чего делать НЕ НАДО: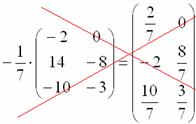
Вносить дробь в матрицу НЕ НУЖНО, во-первых, это только затрудняет дальнейшие действия с матрицей, во-вторых, затрудняет проверку решения преподавателем (особенно, если 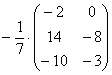 – окончательный ответ задания).
И, тем более, НЕ НАДО делить каждый элемент матрицы на минус семь:
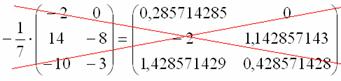
Из статьи Математика для чайников или с чего начать, мы помним, что десятичных дробей с запятой в высшей математике стараются всячески избегать.
Единственное, что желательно сделать в этом примере – это внести минус в матрицу:
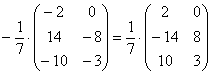
А вот если бы ВСЕ элементы матрицы делились на 7 без остатка, то тогда можно (и нужно!) было бы поделить.
Пример:
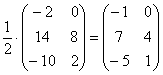
В этом случае можно и НУЖНО умножить все элементы матрицы на  , так как все числа матрицы делятся на 2 без остатка.
Примечание: в теории высшей математики школьного понятия «деление» нет. Вместо фразы «это поделить на это» всегда можно сказать «это умножить на дробь». То есть, деление – это частный случай умножения.
3) Действие третье. Транспонирование матрицы.
Для того чтобы транспонировать матрицу, нужно ее строки записать в столбцы транспонированной матрицы.
Пример:
Транспонировать матрицу 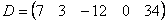
Строка здесь всего одна и, согласно правилу, её нужно записать в столбец:
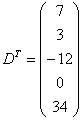 – транспонированная матрица.
Транспонированная матрица обычно обозначается надстрочным индексом  или штрихом справа вверху.
Пошаговый пример:
Транспонировать матрицу 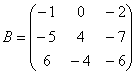
Сначала переписываем первую строку в первый столбец:
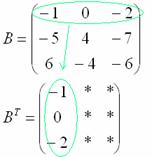
Потом переписываем вторую строку во второй столбец: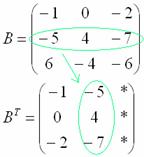
И, наконец, переписываем третью строку в третий столбец:
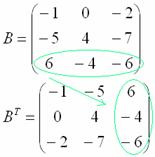
Готово. Образно говоря, транспонировать – это значит взять матрицу за правый верхний угол и аккуратно повернуть её «на себя» по диагонали, «стряхивая» числа в столбцы транспонированной матрицы. Такая вот у меня ассоциация.
4) Действие четвертое. Сумма (разность) матриц.
Сумма матриц действие несложное.
НЕ ВСЕ МАТРИЦЫ МОЖНО СКЛАДЫВАТЬ. Для выполнения сложения (вычитания) матриц, необходимо, чтобы они были ОДИНАКОВЫМИ ПО РАЗМЕРУ.
Например, если дана матрица «два на два», то ее можно складывать только с матрицей «два на два» и никакой другой!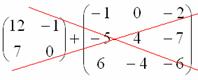
Пример:
Сложить матрицы 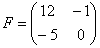 и
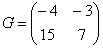
Для того чтобы сложить матрицы, необходимо сложить их соответствующие элементы:
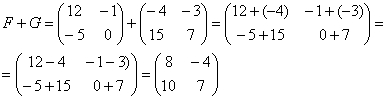
Для разности матриц правило аналогичное, необходимо найти разность соответствующих элементов.
Пример:
Найти разность матриц 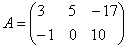 ,
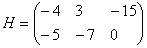
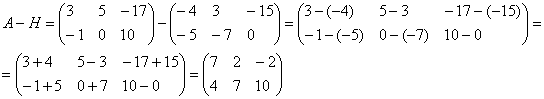
А как решить данный пример проще, чтобы не запутаться? Целесообразно избавиться от лишних минусов, для этого внесем минус в матрицу  :
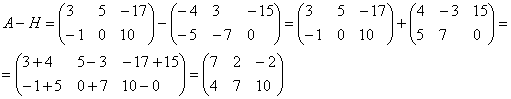
Примечание: в теории высшей математики школьного понятия «вычитание» нет. Вместо фразы «из этого вычесть это» всегда можно сказать «к этому прибавить отрицательное число». То есть, вычитание – это частный случай сложения.
5) Действие пятое. Умножение матриц.
Чем дальше в лес, тем толще партизаны. Скажу сразу, правило умножения матриц выглядит очень странно, и объяснить его не так-то просто, но я все-таки постараюсь это сделать, используя конкретные примеры.
Какие матрицы можно умножать?
Чтобы матрицу  можно было умножить на матрицу
 нужно, чтобы число столбцов матрицы
 равнялось числу строк матрицы
 .
Пример:
Можно ли умножить матрицу  на матрицу
 ?
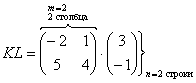
 , значит, умножать данные матрицы можно.
А вот если матрицы переставить местами, то, в данном случае, умножение уже невозможно!
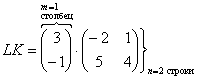
 , следовательно, выполнить умножение невозможно:
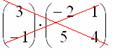
Не так уж редко встречаются задания с подвохом, когда студенту предлагается умножить матрицы, умножение которых заведомо невозможно.
Следует отметить, что в ряде случаев можно умножать матрицы и так, и так.
Например, для матриц,  и
 возможно как умножение
 , так и умножение

Как умножить матрицы?
Умножение матриц лучше объяснить на конкретных примерах, так как строгое определение введет в замешательство (или помешательство) большинство читателей.
Начнем с самого простого:
Пример:
Умножить матрицу  на матрицу

Я буду сразу приводить формулу для каждого случая:
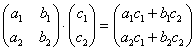 – попытайтесь сразу уловить закономерность.
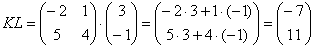
Пример сложнее:
Умножить матрицу  на матрицу

Формула: 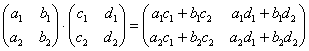
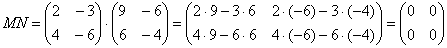
В результате получена так называемая нулевая матрица.
Попробуйте самостоятельно выполнить умножение  (правильный ответ
 ).
Обратите внимание, что  ! Это почти всегда так!
Таким образом, при умножении переставлять матрицы нельзя!
Если в задании предложено умножить матрицу  на матрицу
 , то и умножать нужно именно в таком порядке. Ни в коем случае не наоборот.
Переходим к матрицам третьего порядка:
Умножить матрицу 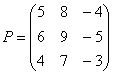 на матрицу

Формула очень похожа на предыдущие формулы: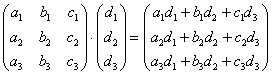
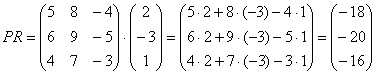
А теперь попробуйте самостоятельно разобраться в умножении следующих матриц:
Умножьте матрицу 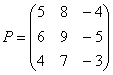 на матрицу
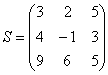
Вот готовое решение, но постарайтесь сначала в него не заглядывать!
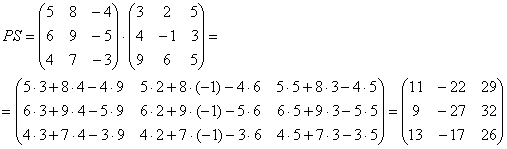
6) Действие шестое. Нахождение обратной матрицы.
Данная тема достаточно обширна, и я вынес этот пункт на отдельную страницу.
А пока спектакль закончен.
После освоения начального уровня рекомендую отработать действия с матрицами на уроке Свойства операций над матрицами. Матричные выражения.
Желаю успехов!
Автор: Емелин Александр
Высшая математика для заочников и не только >>>
(Переход на главную страницу)


